
Материалы по тегу: google cloud platform
|
30.10.2026 [22:58], Владимир Мироненко
Alphabet не оправдала ожиданий инвесторов по выручке и прибыли — акции упали на 12 %Акции Alphabet подешевели более чем на 12 % после публикации отчёта за III квартал, завершившийся 30 сентября 2026 года. Выручка и операционная прибыль не оправдали ожиданий аналитиков, несмотря на то что выручка облачного подразделения Google Cloud более чем удвоилась. Из-за падения котировок рыночная капитализация Alphabet сократилась более чем на $500 млрд. Выручка компании выросла на 25 % по сравнению с аналогичным периодом прошлого года и достигла $127,58 млрд, но аналитики ожидали ещё более высоких продаж — на уровне $128,22 млрд (по данным SiliconANGLE). Скорректированная разводнённая прибыль на акцию (Non-GAAP) составила $2,67, что тоже ниже целевого показателя Уолл-стрит в $3,02 на акцию. Снизилась и чистая прибыль (GAAP) — с $34,98 млрд или $2,87 на разводнённую акцию годом ранее до $26,17 млрд или $2,12 на акцию. Операционная прибыль также оказалась ниже ожиданий Уолл-стрит — $40,58 млрд против $43,19 млрд. 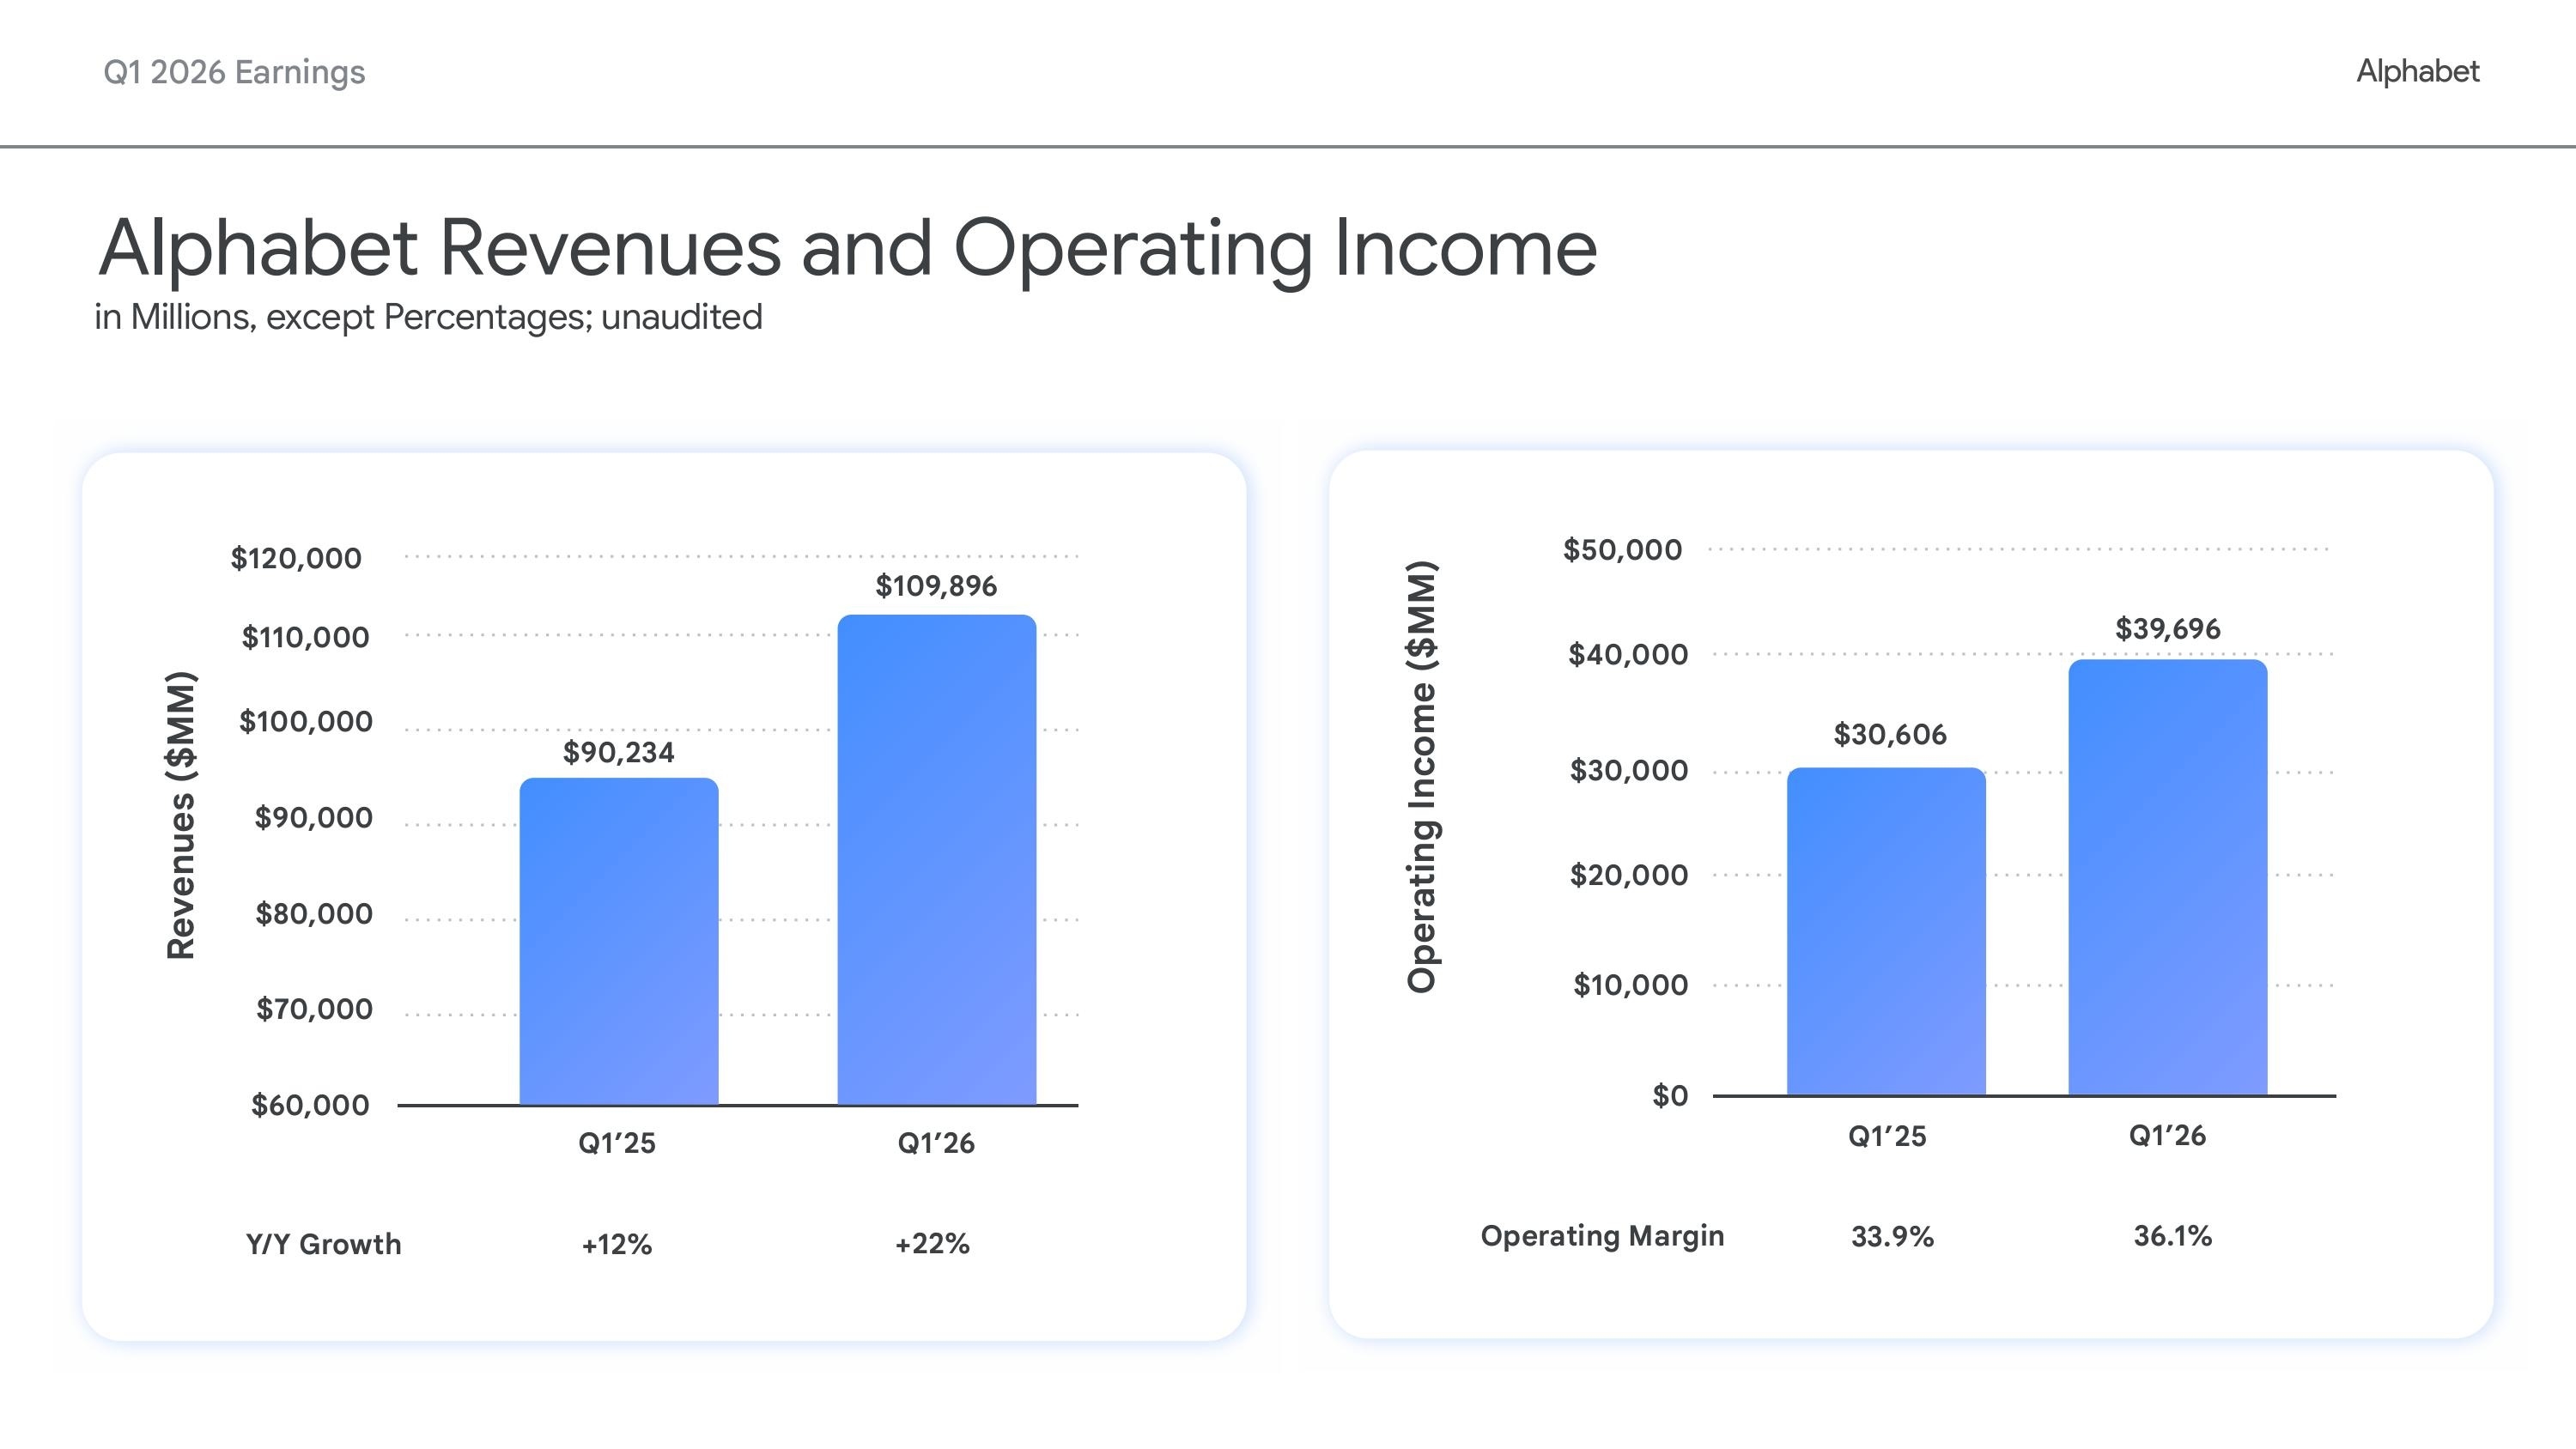
Источник изображений: Alphabet Особенно тревожным сигналом для инвесторов стал отрицательный свободный денежный поток в $9,07 млрд (ожидали + $2,7 млрд), несмотря на снижение капитальных затрат до $51,36 млрд против прогноза в $55,09 млрд. Второй квартал подряд Alphabet демонстрирует отрицательный денежный поток — резкий поворот для компании, которая долгое время была одним из самых эффективных генераторов денежных средств в технологическом секторе В предыдущем квартале из-за масштабных инвестиций в расширение облачных мощностей и разработку ИИ Alphabet тоже потратила больше, чем заработала, — на $5,9 млрд. Это стало первым случаем за 22 года пребывания компании в статусе публичной, когда её свободный денежный поток стал отрицательным. Долговая нагрузка Alphabet резко усилилась: долгосрочный долг подскочил до $125,1 млрд с $21,6 млрд годом ранее (+479 % год к году). Финансовый директор Анат Ашкенази (Anat Ashkenazi) сообщила, что Alphabet по-прежнему планирует значительно увеличить капитальные затраты к 2027 году по сравнению с прогнозируемыми на текущий год показателями ($195–$205 млрд) — до более чем $300 млрд. Хотя конкретная сумма расходов на 2027 год не была названа, перспектива их значительного роста обеспокоила инвесторов. «Цифра в $300 млрд (капитальных затрат) может напугать рынок, особенно учитывая, что свободный денежный поток сейчас стал отрицательным», — отметил Джереми Салтсбург (Jeremy Saltsburg), старший инвестиционный директор в Check Capital. Также были зафиксированы убытки по инвестициям в ИИ стартапы ($8,66 млрд), несмотря на внушительную выручку от долевых вложений в ИИ-компании, такие как Anthropic PBC и Space Exploration Technologies ($99,03 млрд). 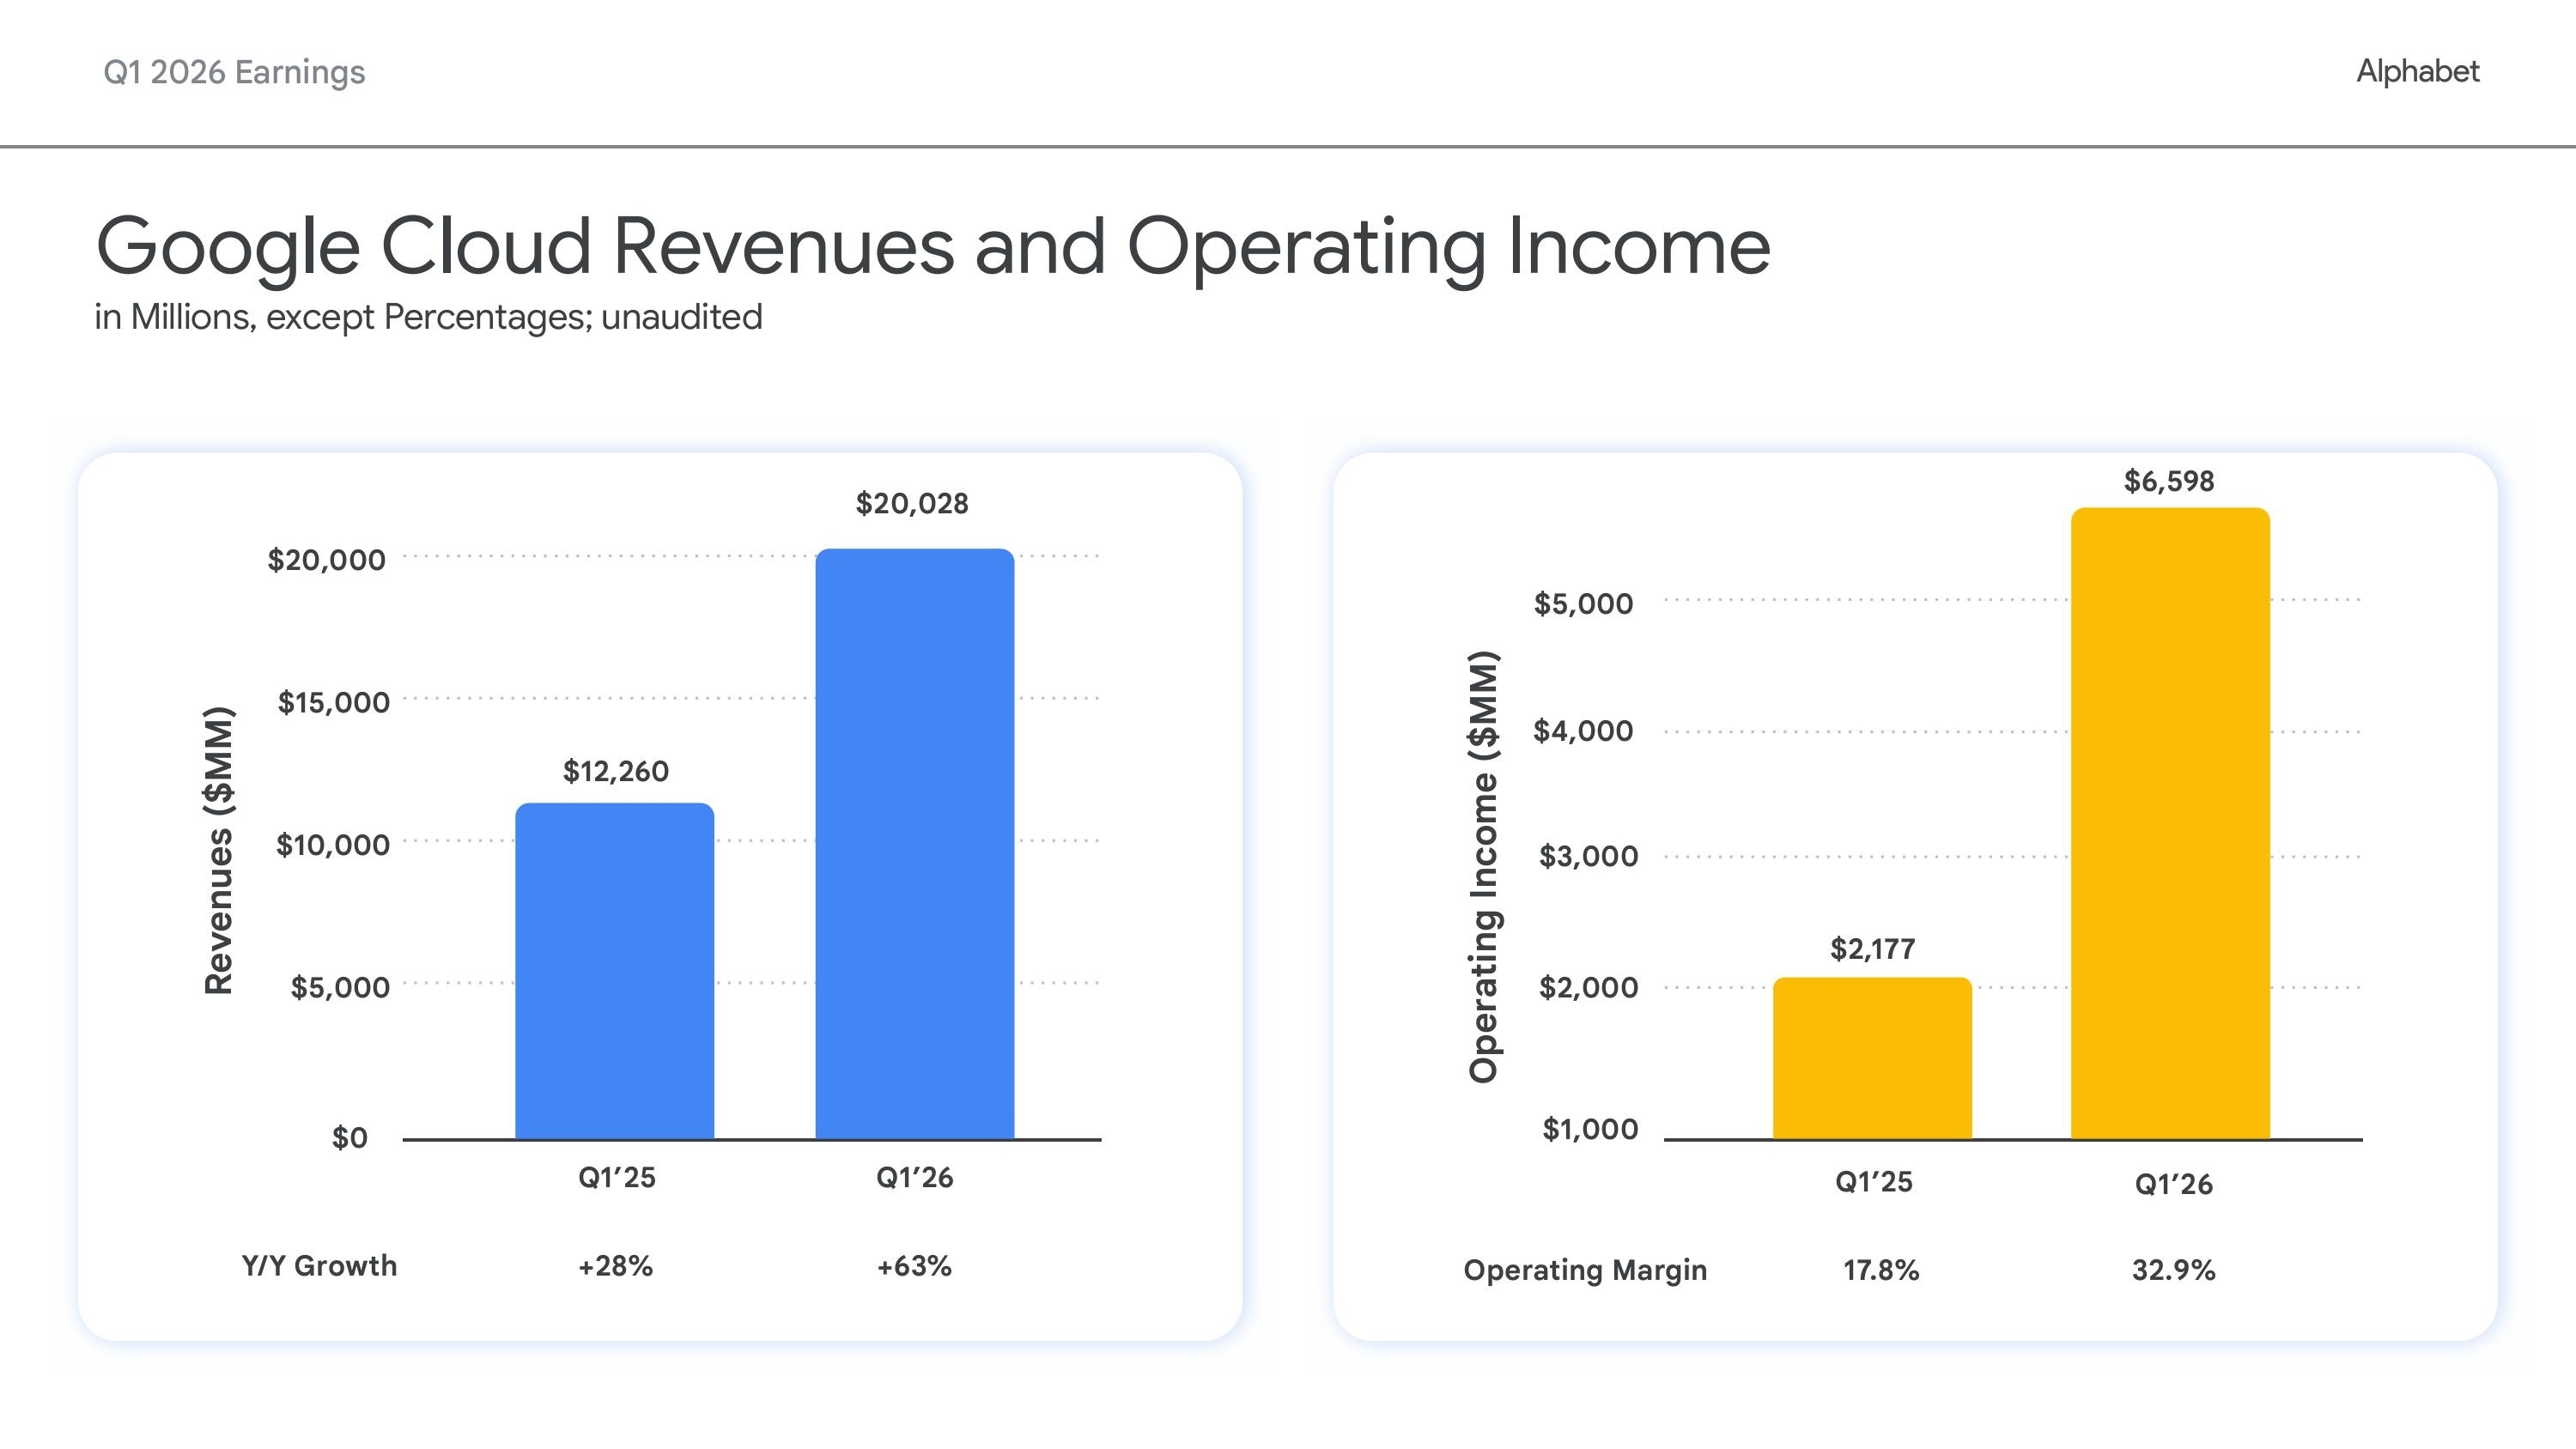 Вместе с тем подразделение Google Cloud увеличило выручку до $30,7 млрд (прогноз — $29,15 млрд), а его операционная прибыль составила $11,1 млрд (прогноз — $9,75 млрд). Операционная рентабельность этого сегмента достигла 36,2 %. «Выручка Google Cloud выросла на 103% благодаря огромному спросу на нашу инфраструктуру и решения в сфере искусственного интеллекта, — заявил гендиректор Сундар Пичаи (Sundar Pichai). — Мы также наблюдаем высокий спрос на наши системы TPU со стороны широкого круга клиентов». Аналитик Investing.com Томас Монтейро (Thomas Monteiro) предупредил, что это одновременно помогает многим конкурентам Alphabet в ИИ-индустрии: они используют облачную инфраструктуру компании для работы своих ИИ-ассистентов и агентов, конкурирующих с собственными решениями Alphabet. «Сейчас Alphabet зарабатывает больше на продаже ИИ-возможностей своим конкурентам, чем на использовании их самостоятельно, и этот разрыв будет и дальше расти в течение следующих нескольких кварталов, если компания радикально не изменит свои модели», — пояснил он. Анат Ашкенази сообщила, что портфель невыполненных обязательств (backlog) Google Cloud вырос до $561 млрд; Alphabet ожидает, что более 55 % этой суммы будет признано в качестве выручки в течение следующих 24 мес. 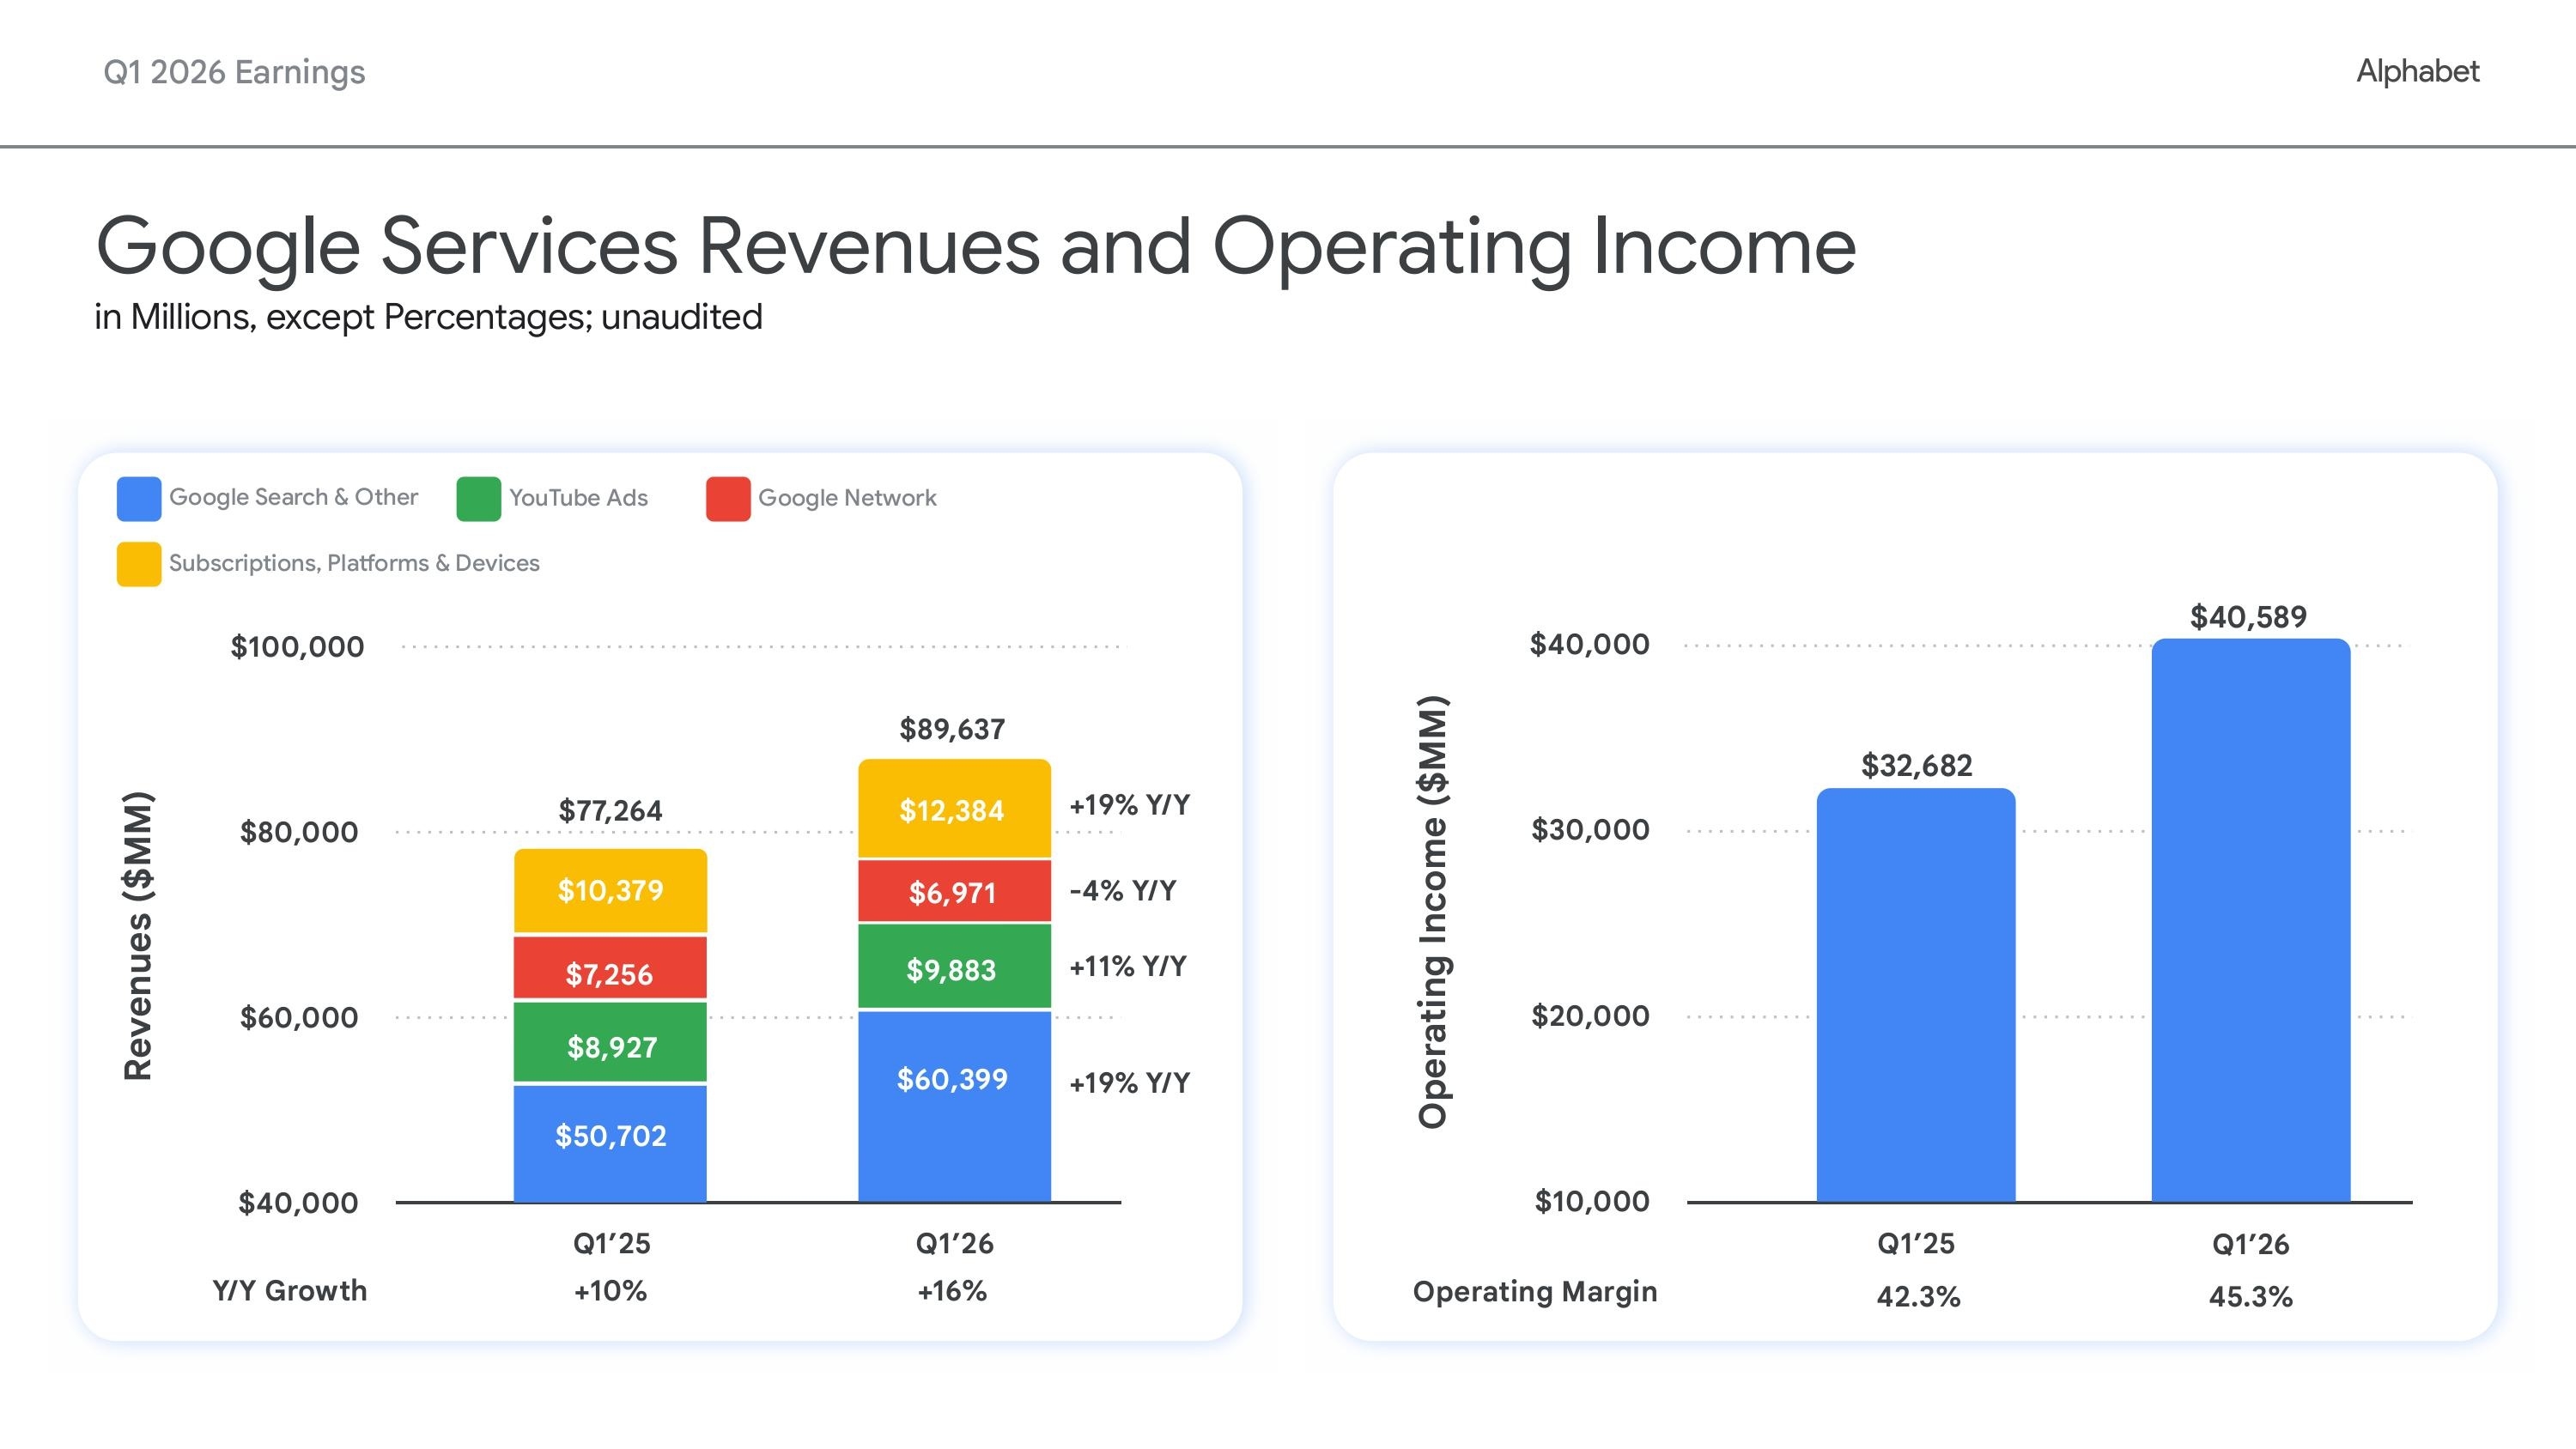 Как сообщается, выручка сегмента Google Services составила $96,3 млрд (прогноз — $98,42 млрд), а операционная прибыль — $39,2 млрд (прогноз — $40,8 млрд). Рекламная выручка Google составила $82,0 млрд против ожидаемых $83,6 млрд. Выручка от сети Google (Google Network) достигла $7,5 млрд, превысив прогноз в $7,2 млрд, в то время как выручка от подписок, платформ и устройств составила $14,3 млрд, что ниже прогнозируемых $14,85 млрд. Выручка от поисковых и прочих сервисов составила $63,4 млрд, что ниже ожидавшихся $64,99 млрд. Рекламная выручка YouTube равняется $11,2 млрд при прогнозе в $11,4 млрд.
23.10.2026 [13:48], Павел Котов
Google Cloud представила Agent Compute Engine — сервис для запуска ИИ-агентовПлатформа Google Cloud анонсировала сервис Agent Compute Engine, оптимизированный для размещения ИИ-агентов, сообщает SiliconANGLE. ИИ-агенты традиционно функционируют в песочницах — здесь размещаются приложения, данные и инструкции пользователей, необходимые для выполнения поставленных задач. Эти среды оснащены механизмами кибербезопасности, блокирующими вредоносные действия. В сервисе Agent Compute Engine такие песочницы реализованы в виде микровиртуальных машин (microVM) — эта технология сочетает аппаратную эффективность контейнеров с уровнем безопасности традиционной виртуализации. В Google использовали возможности гипервизоров по изоляции ВМ друг от друга, чтобы предотвратить распространение вредоносов. Микро-ВМ работают на специально настроенном оборудовании без сохранения состояния. Для хранения данных используется неизменяемая файловая система. Целостность прошивки оборудования проверяется с помощью чипов кибербезопасности Titan, а его CPU имеют средства защиты от атак по сторонним каналам. У microVM есть лишь ограниченный доступ к ресурсам хранения данных — если злоумышленники установят контроль над одной из песочниц, они не смогут ни прочитать, ни удалить их. Сеть, соединяющая оборудование с остальной инфраструктурой ЦОД, также имеет дополнительную защиту: трафик проходит через несколько прокси-серверов. 
Источник изображения: Ameer Basheer / unsplash.com Когда ИИ-агент завершает работу, песочница, в которой он функционировал, должна оставаться доступной, потому что его могут активировать снова. Такие простаивающие песочницы могут потреблять значительный объём ресурсов и приводить к росту затрат. Agent Compute Engine отслеживает переход песочницы в состояние простоя и отключает её, а когда песочница снова становится востребованной, сервис оперативно её активирует. «Это позволяет разместить на одном физическом узле значительно больше microVM для агентов, чем при использовании традиционных ВМ. Мы дополнили решение необходимыми для работы агентов функциями: созданием снимков и форками, возможностями перемотки и отката состояния. Это позволяет эффективно использовать систему без дублирования ресурсов», — пояснили в Google Cloud. Некоторые агенты для доступа к приложениям используют учётные данные пользователей — эти данные хранятся вне песочницы, в которой запущен агент, подчеркнули в Google. За счёт этого злоумышленники, даже получив контроль над песочницей, не смогут похитить конфиденциальную информацию. Когда агенту требуется войти в приложение, служба Google Cloud Agent Gateway извлекает соответствующие учётные данные и передаёт их в приложение от имени агента. В ближайшие месяцы Agent Compute Engine заработает с новой версией Agent Gateway — последняя служба помогает клиентам блокировать небезопасный трафик агентов, и она получит функцию маршрутизации моделей. Каждый запрос агента станет направляться к той модели, которая сможет обработать его наиболее эффективно. В Agent Gateway также появится инструмент для контроля расходов, связанных с инференсом.
22.10.2026 [17:42], Павел Котов
В Google Cloud появятся новейшие ИИ-модели OpenAIOpenAI объявила о планах сделать свои новейшие большие языковые модели доступными в Google Cloud. Они появятся в сервисе Model Garden, который представляет доступ к более чем 200 нейросетям от самой Google, её партнёров, а также к открытым проектам. В каталоге представлены не только большие языковые модели, но и более компактные специализированные решения, предназначенные для конкретных задач, например, для перевода текстов, сообщает SiliconANGLE. Первой моделью, которую OpenAI разместит в Google Cloud, станет флагманская GPT-6 Astra. Клиенты Google Cloud также получат доступ к моделям GPT-6.1 Sol и GPT-6 Luna — облегчённым версиям Astra, которые OpenAI представила в конце сентября. Качество генерации у них несколько ниже, но они существенно дешевле: Sol в пять, а Luna — в сто раз меньше, чем Astra. Облачные провайдеры часто предлагают скидки корпоративным клиентам, готовым взять на себя долгосрочные обязательства по расходам, — клиенты Google Cloud смогут воспользоваться этой схемой, отметили в OpenAI. Модели Astra, Sol и Luna появятся в сервисе Google Model Garden в ближайшие недели. 
Источник изображения: cloud.google.com Далее компании планируют интегрировать их в панель инфраструктурных служб Confidential Compute. Серверные CPU, в том числе используемые Google, поддерживают функцию безопасности TEE (Trusted Execution Environment). Она предполагает шифрование части памяти на хосте таким образом, что доступ к ней остаётся только у конкретной рабочей нагрузки — в службах Confidential Compute эта функция используется. OpenAI также планирует сделать свои модели доступными в продуктах самой Google, в том числе в сервисе помощника по написанию кода Antigravity и в ИИ-агенте Gemini Agent.
22.10.2026 [00:36], Владимир Мироненко
Google Cloud и NVIDIA запустят в ноябре инстансы на базе Vera Rubin NVL72Google Cloud и NVIDIA объявили, что в следующем месяце в Европе станут общедоступны инстансы Google Cloud A5X на базе систем NVIDIA Vera Rubin NVL72. Они предоставят клиентам комплексную платформу для обучения моделей, инференса и масштабного обучения с подкреплением. A5X интегрирует архитектуру Vera Rubin в систему Google Cloud AI Hypercomputer, объединяя вычислительные мощности, сетевые ресурсы и системы хранения данных для поддержки обучения на основе опыта. A5X используют системы NVIDIA Vera Rubin NVL72, сетевые адаптеры NVIDIA ConnectX-9 SuperNIC, сеть Virgo Network и передовую технологию жидкостного охлаждения четвертого поколения от Google Cloud. Сообщается, что Google Cloud планирует расширить инфраструктуру на базе архитектуры Vera Rubin, доведя количество ускорителей Rubin до 960 тыс. единиц, размещённых на различных площадках. По мере развёртывания агентских систем компаниям необходимо обеспечивать защиту проприетарных моделей и конфиденциальных данных, лежащих в основе этих систем, даже при использовании инфраструктуры сторонней организации. Google Cloud станет одним из первых облачных провайдеров, предлагающих NVIDIA Confidential Computing в масштабе стойки на bare-metal-инстансах, таких как A4X Max на базе NVIDIA GB300 NVL72. 
Источник изображения: NVIDIA Кроме того, Google Cloud делает конфиденциальные вычисления (Confidential Computing) общедоступными на виртуальных машинах G4 на базе ускорителей NVIDIA RTX PRO 6000 Blackwell Server Edition, предлагая гибкую платформу для конфиденциального инференса и тонкой настройки. Клиенты, включая Vertebrae, Polaris Cloud и Confidential Core AI, используют ВМ Confidential G4 для обеспечения конфиденциальности разговоров, проверяемой работы агентов и корпоративного ИИ, управляемого в рамках заданных политик. Google Cloud и NVIDIA также изучают возможности комплекса технологий NVIDIA DSX MaxLPS для инфраструктуры на базе Vera Rubin, чтобы оптимизировать производительность на Вт и расширить возможности в рамках доступного бюджета электропитания ЦОД.
21.10.2026 [15:03], Павел Котов
Google представила TorchTPU — средство для работы с PyTorch на TPUGoogle представила программный комплекс TorchTPU с открытым исходным кодом, предназначенный для запуска ИИ-моделей с использованием фреймворка PyTorch на ускорителях TPU. Проект призван упростить использование ускорителей Google в обучении и инференсе ИИ; поддерживаются популярные программные средства — создавать отдельную программную среду для TPU не требуется. Разработанный совместно с командой PyTorch в Meta✴ инструментарий TorchTPU позволяет запускать существующие проекты в PyTorch с минимальными изменениями кода, используя привычный API. Поддерживаются отладка в обычном режиме PyTorch и механизмы распределенных вычислений. Google заручилась поддержкой Hugging Face, благодаря чему представленные на ИИ-платформе открытые модели могут запускаться нативно через TorchTPU — поддерживаются библиотеки Transformers v5 и Diffusers. Программный модуль vLLM для TorchTPU поддерживает одновременную обработку множества запросов, квантизацию и распределение вычислений между чипами TPU; стандартные средства управления вычислениями и обработки запросов сохранены. Для TPU адаптирован инструмент SGLang — он позволяет ускорять сложные многоэтапные задачи, в том числе выполняемые ИИ-агентами; поддерживаются повторные обращения к KV-кешу и повторяющиеся префиксы запросов. Версия SGLang-TorchTPU сохранила механизмы выполнения задач, распределения запросов и API. Средства обмена данными с HiCache помогают сократить задержку и оптимизировать вывод при сложной многоэтапной генерации. 
Источник изображения: youtube.com/@googlecloudtech Совместно с Red Hat, IBM и сообществом разработчиков выпущен роутер llm-d 1.0 — он направляет запросы к экземплярам модели, где уже сохранен контекст, а также разделяет обработку входного запроса и генерацию ответа по вычислительным ресурсам, что позволяет использовать их эффективнее. В Google Kubernetes Engine этот инструмент поддерживает запуск моделей как на GPU, так и на TPU. Google интегрировала TorchTPU с TorchTitan — инструментом распределённого обучения крупных моделей; поддерживаются, в частности, Llama 3, Qwen 3 и FLUX.1. Поддержка появилась в VeRL — одном из наиболее популярных фреймворков для обучения с подкреплением. Заявлено о поддержке TorchTPU в Ray — этот инструмент для распределения вычислительных задач позволяет объединить обработку данных, обучение, и инференс в рабочий процесс с использованием CPU, GPU и TPU. В экосистему PyTorch вошла библиотека LiteRT, предназначенная для запуска моделей на пользовательских устройствах. Google также представила предварительную версию TPU agent suite — при помощи плагинов этот набор инструментов помогает автоматизировать первоначальную настройку, диагностику и оптимизацию моделей в PyTorch. Поддержку PyTorch на своих ускорителях реализовали также Amazon, Intel и Meta✴.
20.10.2026 [18:44], Павел Котов
В западноевропейском сегменте Google Cloud произошёл масштабный сбойПричиной отключения ряда онлайн-сервисов для клиентов в Западной Европе стал «инцидент с электроснабжением», сообщили в Google Cloud. К настоящему моменту работоспособность облачных сервисов полностью восстановлена. Системы вышли из строя 20 октября в 09:08 МСК — возникли неполадки в зоне доступности europe-west-2-b, одной из трёх в лондонском регионе. Полностью работу всех сервисов удалось восстановить в 17:03 МСК. Среди затронутых сервисов оказались BigQuery Data Transfer Service, Cloud Filestore, Cloud Run, Google App Engine, Google Cloud NetApp Volumes, Google Kubernetes Engine и Managed Service for Apache Kafka. 
Источник изображения: Ameer Basheer / unsplash.com В результате крупномасштабного сбоя возникли неполадки в работе ресурсов Lloyds Bank, HSBC, Royal Mail, Rightmove, DPD, BT, Cloudflare, Screwfix и Revolut. Причиной проблемы стал «инцидент с электроснабжением». В общей сложности из строя вышли 38 сервисов, подсчитал давший ресурсу The Register комментарий эксперт. Сбой подчеркнул, насколько сильно современные облачные экосистемы зависят друг от друга: при возникновении проблемы в одном из ключевых облачных регионов по каскаду возникают отказы в работе приложений, API, баз данных, систем аутентификации, платёжных платформ, аналитики и сторонних SaaS-продуктов. Чтобы обеспечить устойчивость сервисов, требуется проектировать архитектуру с учётом подобных региональных сбоев. Ресурсы следует развёртывать в нескольких регионах, обеспечивать возможность переносить рабочие нагрузки и предусматривать процедуры восстановления после аварий, добавил эксперт. Платформа Google Cloud время от времени сталкивается с масштабными сбоями, которые выводят из строя многочисленные сервисы. В июне сервисы Google Cloud в Индии около недели работали с перебоями из-за произошедшего в одном из ЦОД в Дели пожара. В июле был зафиксирован 15-часовой сбой сервиса в Нидерландах по вине проблем питания и охлаждения в ЦОД. А в сентябре регион us-central1-b на несколько часов прекратил работу из-за человеческого фактора.
09.10.2026 [21:47], Руслан Авдеев
Google «выжмет» из АЭС Constellation ещё 890 МВт для своих ИИ ЦОДGoogle объявила о заключении долгосрочного стратегического соглашения с энергокомпанией Constellation Energy, забронировав значительные мощности АЭС для своей масштабной экосистемы ИИ ЦОД, сообщает Silicon Angle. PPA сроком на 20 лет позиционируется как «партнёрство в сфере чистой энергетики». В рамках сделки Constellation потратит на обновление и модернизацию 11 энергоблоков на шести объектах в Иллинойсе, Нью-Джерси и Пенсильвании $4,3 млрд. Речь, в частности, идёт об установке новых передовых турбин, современных паровых генераторов и передовых цифровых систем контроля. Всё это поможет повысить эффективность электростанций и даст энергосистеме PJM Interconnection, обслуживающей 13 штатов и 67 млн потребителей, дополнительные 890 МВт. Google не сообщила, сколько именно она будет платить за «обновлённую» атомную энергию, но соглашение даст PJM гарантии стабильной выручки, необходимой для многомиллиардной модернизации, и без роста расходов для рядовых потребителей. Кроме того, дополнительно заключён отдельный договор на 15 лет о поставках 2,7 ГВт с действующих электростанций Constellation. Google Cloud в рамках сделки получила и нового клиента — компания обеспечит Constellation облачными вычислительными ресурсами в течение пяти лет, а также доступом к платформе Gemini Enterprise. Это позволит генерирующей компании применить ИИ для выбора новых площадок, управления отключениями энергии и ремонтом, а заодно защитить критически важную инфраструктуру и оптимизировать распределение нагрузок между генерирующими объектами. Google пообещала, что соглашение позволит сохранить 4,4 тыс. рабочих мест для высококвалифицированных кадров. По словам Google, новый договор позволит обеспечить американцев дополнительной электроэнергией без строительства новых объектов. Подчёркивается, что в США действуют 94 реактора, поэтому страна располагает шансом эффективно нарастить возможности АЭС за счёт уже работающих энергоблоков. 
Источник изображения: Johannes Plenio/unsplash.com Ранее Google заключила соглашения с NextEra Energy о возобновлении работы «спящего» реактора Duane Arnold в Айове, а также с Southern Co., которая обязалась модернизировать две своих действующих электростанции. В мае 2025 года сообщалось, что Google и Elementl реализуют в США три 600-МВт атомных проекта. Кроме того, в конце 2025 года она договорилась с Commonwealth Fusion Systems о покупке термоядерной энергии, в августе того же года — с Kairos о подключении к SMR. В сентябре сообщалось, что Google заключила PPA с финской Fortum в расчёте на ресурсы местной АЭС. Constellation уже взаимодействует с другими гиперскейлерами. Так, недавно она сообщила, что AWS согласилась покупать 690 МВт энергии АЭС Calvert Cliffs в Мэриленде в рамках соглашения сроком 20 лет. Сделка позволит направить $3 млрд на модернизацию энергоблоков. Одним из первых прямых соглашений с гиперскейлерами стала сделка с Microsoft, заключенная в 2024 году сроком на 20 лет. Контракт позволял дать «второе дыхание» АЭС Three Mile Island в Пенсильвании. В числе прочих гиперскейлеров, инвестирующих в ядерную энергию — Oracle и Meta✴. Первая планирует использовать электричество АЭС в своём новом проекте ЦОД в Висконсине в рамках соглашения, позволяющего переложить $300 млн расходов на энергетику с потребителей коммунальных услуг на других участников рынка. Meta✴, в свою очередь, заключила PPA с Vistra Corp. на 20 лет. Спрос на энергию подстёгивает и развитие SMR. Например, в августе Valar Atomics привлекла $1 млрд на финансирование массового производства своих прототипов SMR. X-energy Reactor привлекла $700 млн только в ноябре, всего за месяц до того, как Radiant Industries заручилась поддержкой на $300 млн на аналогичный проект.
21.09.2026 [08:54], Владимир Мироненко
224 vCPU и почти 6 Тбайт RAM: Google объявила об общедоступности инстансов M4NGoogle объявила об общедоступности инстансов M4N в Google Compute Engine. Компания отметила, что это второе предложение в семействе ВМ, оптимизированных для работы с сетью и блочными хранилищами. Серия M4N специально разработана для задач, требующих больших объёмов памяти и высокой интенсивности операций I/O. Как утверждает Google, по сравнению с аналогичными предложениями других крупных облачных провайдеров, инстансы M4N обеспечивают самые высокие показатели IOPS и пропускной способности на ядро в классе инстансов с большим объёмом памяти, а также позволяют снизить совокупную стоимость владения (TCO) для СУБД Oracle более чем на 20 %. Серия M4N дополняет существующие семейства ВМ, оптимизированных для работы с памятью (M1, M2, M3, M4 и X4). Новая серия позиционируется не как замена этим продуктам, а как более специализированное решение для приложений, в которых «узким местом» стали ограничения подсистемы хранения данных или сети. Также сообщается, что M4N — это первый в отрасли инстанс, оптимизированный для работы с сетью и блочными хранилищами, который отличается повышенным соотношением объёма памяти к количеству ядер (до 26:1) и большим максимальным объемом памяти (6 Тбайт). Инстансы M4N на базе процессоров Intel Xeon Emerarld Rapids дополнены функциями разгрузки фирменного аппаратного решения Titanium и обеспечивают совокупную производительность хранилища на уровне хоста до 25 тыс. МиБ/с (25 ГиБ/с) и до 1 млн IOPS с дисками Hyperdisk Extreme, что вдвое превышает показатели производительности блочных хранилищ для текущих инстансов M4. 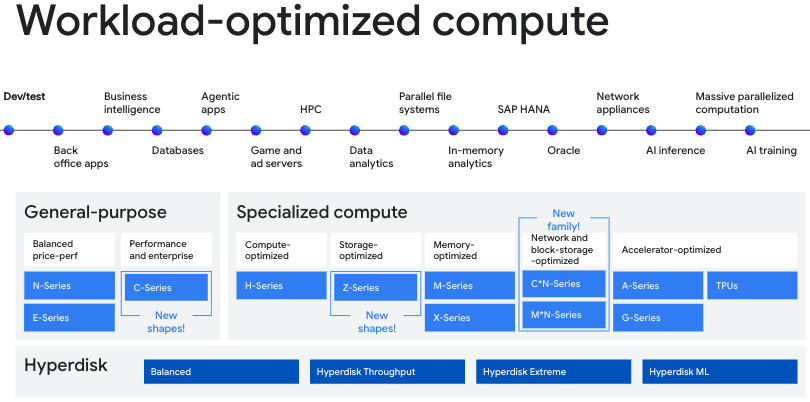
Источник изображения: Google Компания отметила, что корпоративные ИТ-подразделения сталкиваются с ростом затрат на лицензирование ПО, стоимость которого привязана к количеству ядер, виртуальных или физических. В связи с этим приходилось идти на компромисс, оплачивая больше вычислительных ядер, чем требовалось для самой задачи, чтобы получить необходимый объём оперативной памяти и достаточную производительность подсистемы хранения данных. M4N меняют этот подход благодаря лучшему в отрасли соотношению объема памяти к количеству vCPU, говорит Google. Они позволяют:
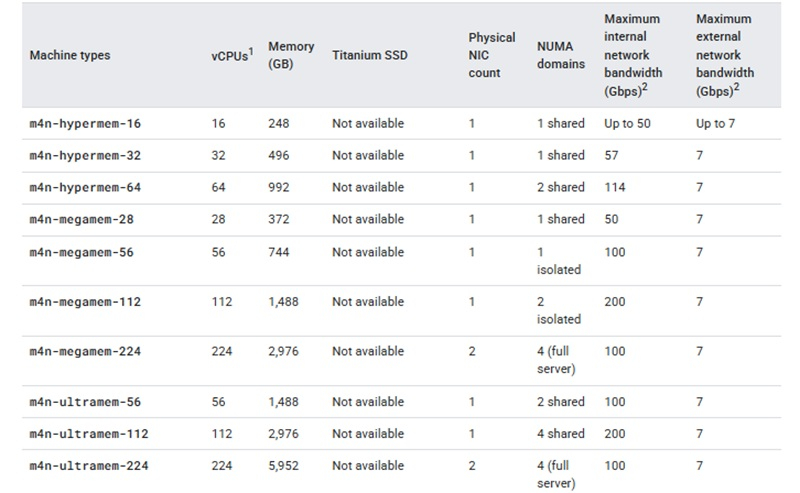
Источник изображения: Google Серия M4N включает 10 инстансов с количеством vCPU в пределах от 16 до 224, объёмом DDR5 от 248 до 5952 Гбайт. Пропускная способность сети достигает 400 Гбит/с для трафика между виртуальными машинами и 200 Гбит/с для исходящего трафика. Инстансы предлагаются с предустановленными конфигурациями, рассчитанными на различные профили рабочих нагрузок. В числе целевых сценариев использования M4N компания указала критически важные корпоративные базы данных, системы генеративного ИИ и компоненты RAG, медицинские информационные системы, ERP, аналитику в реальном времени и EDA.
09.09.2026 [17:56], Владимир Мироненко
Google опережает ближайшего конкурента по продажам ИИ-ускорителей вдвоеGoogle значительно опережает конкурентов по продажам ИИ-ускорителей. Как сообщил исполнительный директор Google Томас Куриан на конференции инвесторов Goldman Sachs, бизнес компании по продажам TPU в два раза больше, чем у ближайшего конкурента-гиперскейлера. Согласно отчёту компании за II квартал 2026 финансового года, её выручка от облачных вычислений выросла год к году на 82 % до $24,77 млрд. При этом Google впервые включила продажи ИИ-ускорителей TPU в доходы от облачных вычислений сторонним компаниям. Куриан заявил, что компания предоставляет лучшую ИИ-инфраструктуру, предлагая три вида чипов — NVIDIA GPU, собственные TPU и кастомные Arm-процессоры Axion. «Мы предлагаем в 2,7 раза лучшие цены на обучение, на 80 % лучшие цены на инференс, на 30 % лучшие цены на процессоры. Всё это позволяет нам выделять наше портфолио среди других поставщиков. Это позволяет нам предлагать решения для финансовых рынков и рынков капитала», — заявил Куриан. По словам Куриана, платформу Gemini Enterprise использует более чем 90 % компаний из списка Fortune 100 и тысячи малых предприятий. Он отметил, что компании хотят использовать её в качестве агента со способностью к рассуждению, который в конечном итоге позволит автоматизировать рабочие процессы. При этом им важны аудит работы ИИ, средства контроля безопасности над ним и возможность управления затратами и бюджетами для ИИ. «У нас есть все эти средства контроля. И мы позволяем людям использовать правильную модель для решения нужной задачи», — сообщил топ-менеджер Google. 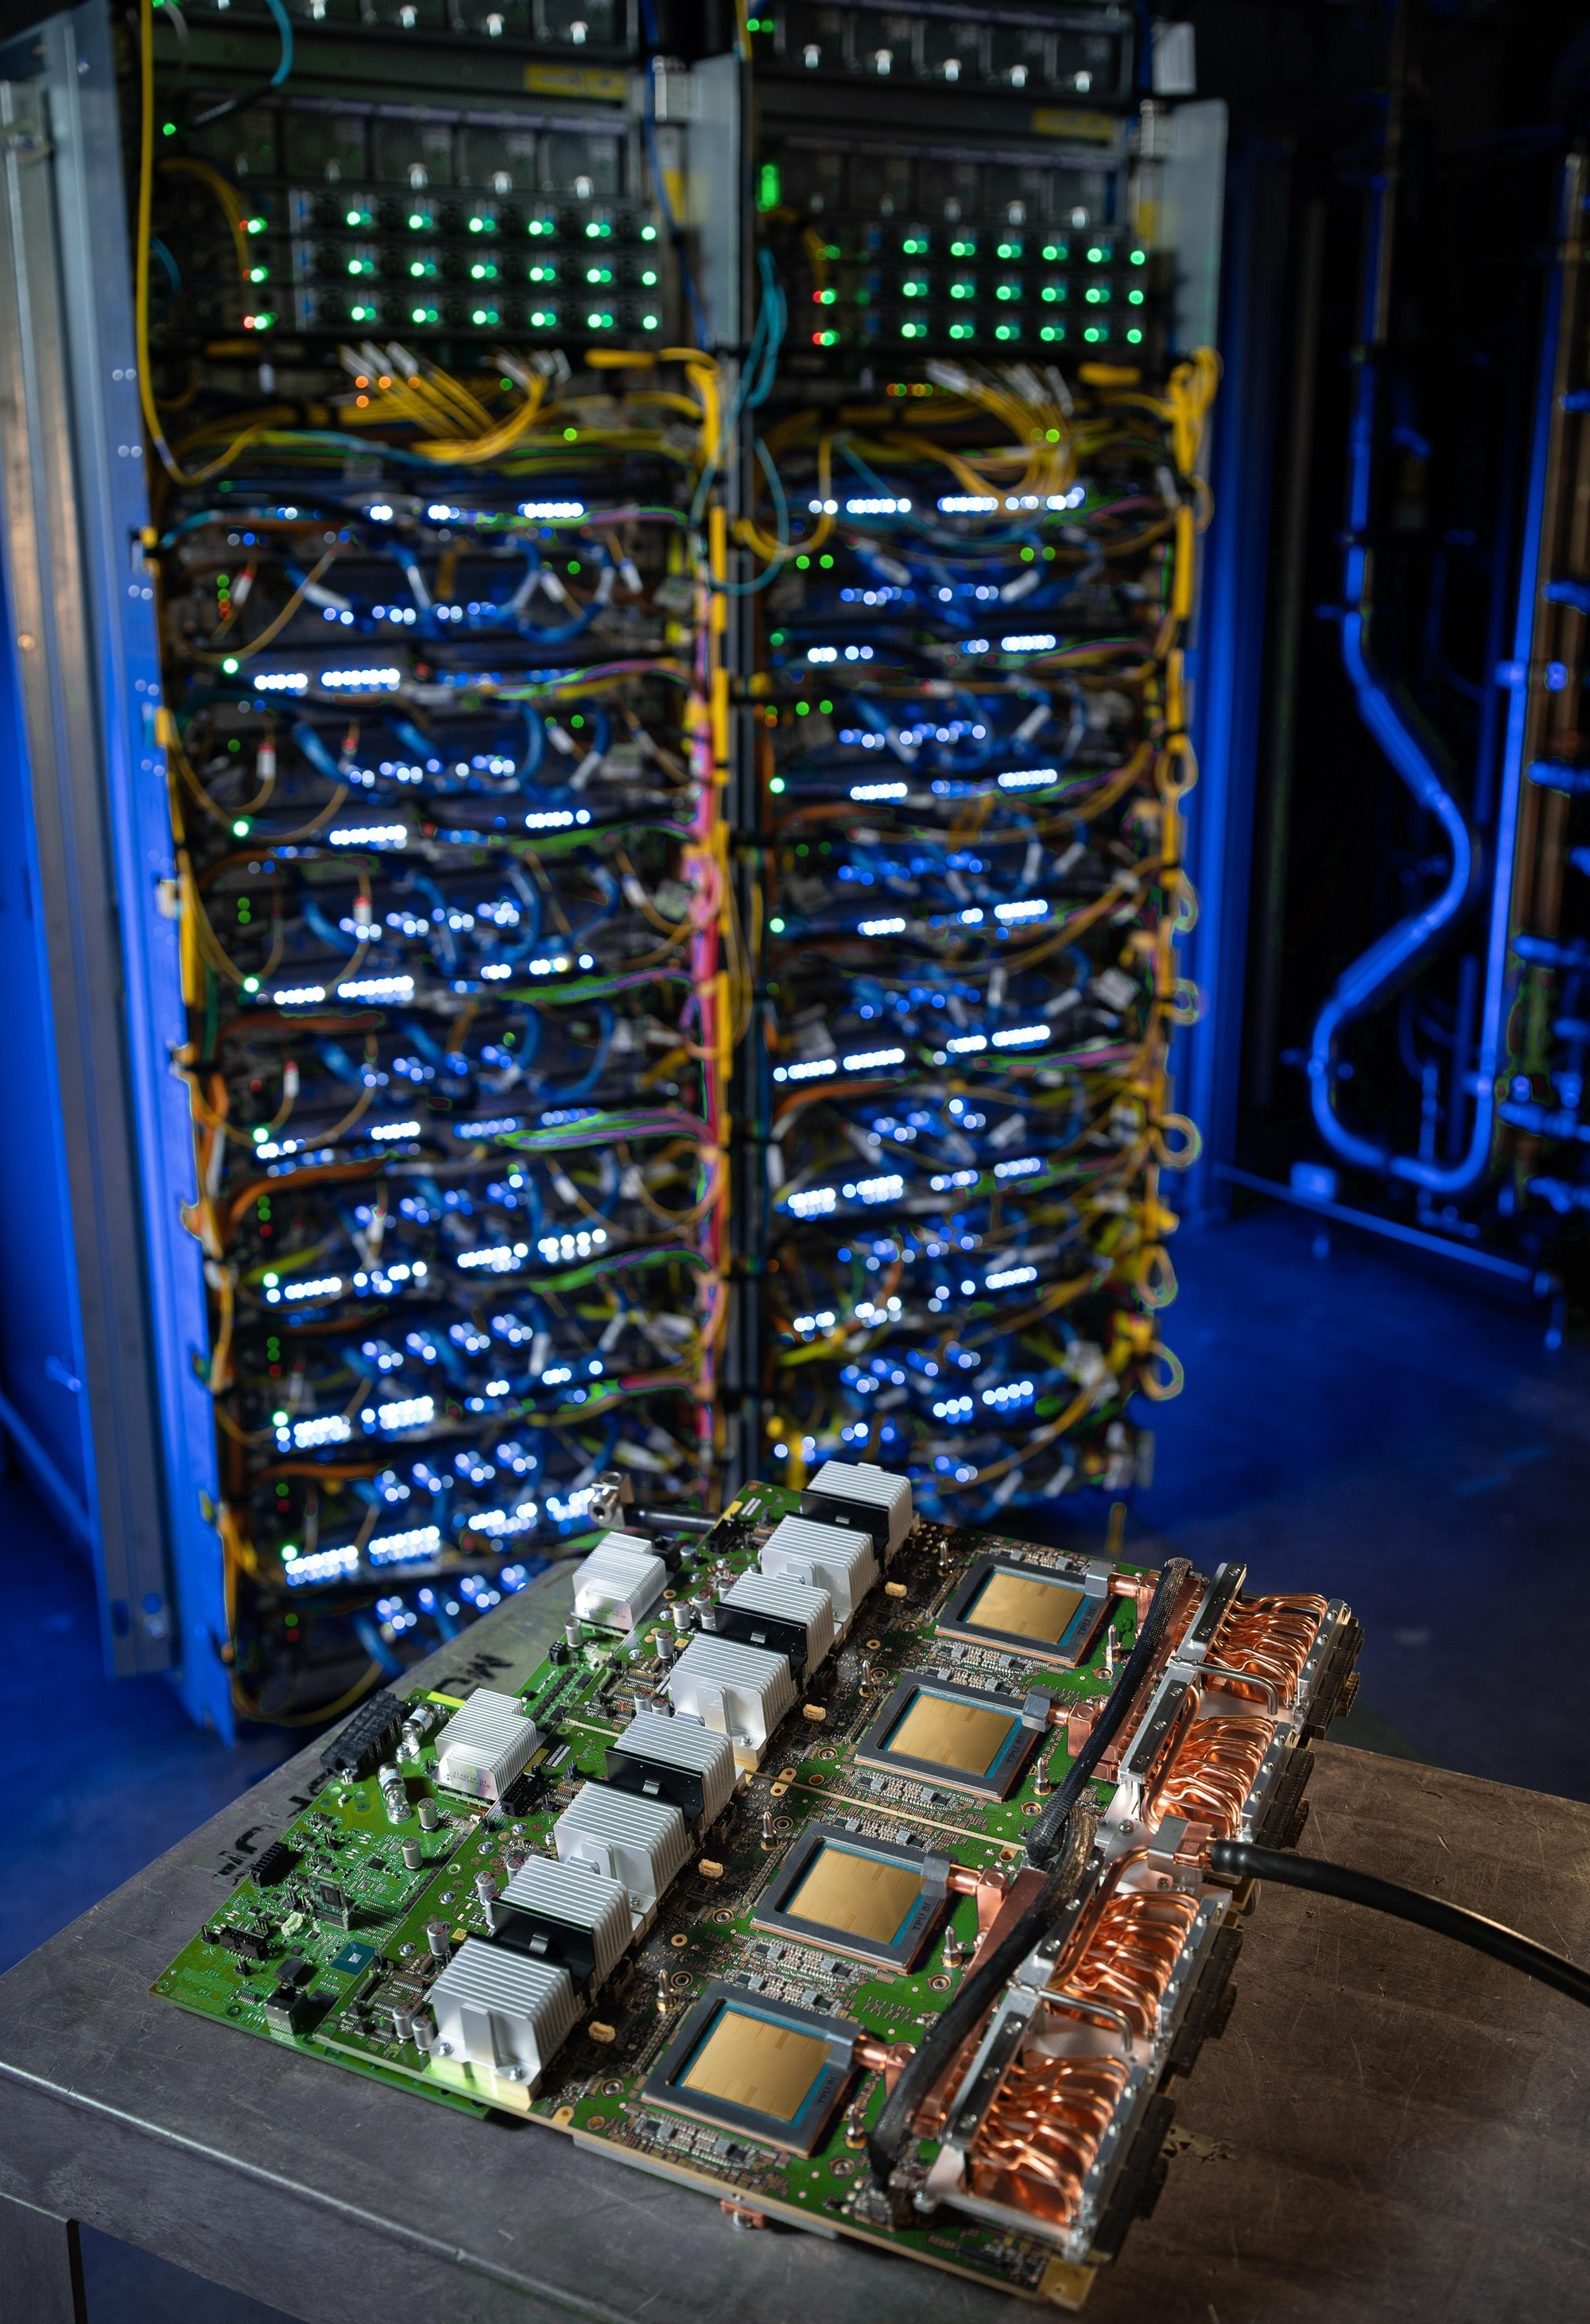
Источник изображения: Google Куриан рассказал, что Google монетизирует системы TPU с помощью трёх бизнес-моделей: аренда TPU в облаке, продажа TPU напрямую для развёртывания в ЦОД клиентов (как в случае с Anthropic) и продажа TPU через совместное предприятие с Blackstone. Morgan Stanley сообщил в августе: «Мы повышаем наши оценки продаж TPU до $27 млрд с валовой прибылью в 30 %. В целом, мы ожидаем, что Google продаст 0,3 ГВт TPU во II половине 2026 года, 3,2 ГВт в 2027 году и 4,2 ГВт в 2028 году. Это означает, что в 2027 и 2028 годах доходы, связанные с TPU, составят $84 млрд и $108 млрд соответственно». Как отметил ресурс techblog.comsoc.org, другие облачные провайдеры тоже развивают свои собственные программы на основе ИИ, чтобы уменьшить зависимость от GPU NVIDIA и оптимизировать стоимость, мощность и производительность в зависимости от рабочей нагрузки. У Amazon есть Trainium, у Microsoft — Maia. Аналитики утверждают, что Amazon опережает Microsoft в продаже ИИ-чипов внешним заказчикам. Meta✴ внедряет ИИ-ускорители MTIA, а Oracle решила вместо разработки собственного чипа создавать крупномасштабные ИИ-кластеры с использованием ускорителей NVIDIA и AMD. К середине 2026 года Meta✴, Amazon, Microsoft и OpenAI ликвидировали отставание по трём ключевым составляющим ИИ-сферы — специализированным чипам, мощностям и моделям, — которыми в 2021 году располагала только Google. Пять из шести крупнейших игроков в области ИИ — Google, Meta✴, Amazon, Microsoft и OpenAI — теперь будут контролировать как минимум два из трёх важнейших компонентов ИИ (чипы, мощности, модели). Эта тенденция к вертикальной интеграции меняет рынок ИИ-инфраструктуры: гиперскейлеры всё чаще используют кастомные чипы для оптимизации затрат и производительности для конкретных рабочих нагрузок, сохраняя при этом стратегическую гибкость за счёт закупок GPU у нескольких поставщиков.
06.09.2026 [19:10], Руслан Авдеев
RTFM-ошибка гиперскейл-уровня: инженер Google Cloud уронил часть облака, разом отключив все оптические кабелиGoogle Cloud раскрыла довольно курьёзную причину частичного сбоя в регионе us-central1-b, который произошёл 1 сентября с 07:41 до 11:52 по тихоокеанскому времени (PT). Часть облака физически отключил от Сети инженер, обслуживавший оборудование, сообщает The Register. Это привело к «серьёзному ухудшению работы сети и изоляции ресурсов». По данным Google, в разгар инцидента объём проходящего трафика в пострадавшей области облака «сократился на 100 %», из-за чего ряд инстансов оказался попросту недоступен пользователям, а потери пакетов ожидаемо выросли. Компания пояснила, что при проектировании облачных ЦОД занимается резервированием маршрутизаторов, но против человеческой «смекалки» ей противопоставить нечего. Система рассчитана на двойные и даже тройные отказы и использует раздельное питание оборудования и несколько ВОЛС. Тем не менее, как оказалось, все эти меры защиты можно обойти, просто выдернув кабели из гнёзд. Сообщается, что непосредственной технической причиной сбоя стало отключение оптоволоконных кабелей в ходе стандартных работ по обслуживанию оборудования. Компания сообщила, что инженер последовательно отключил 100 % оптоволоконных соединений всего за 13 мин. Характер ошибки и высокая скорость работы «инициативного» сотрудника не позволили вовремя предупредить его о неправильных действиях до полного отключения. 
Источник изображения: Jimmy Nilsson Masth/unsplash.com После отключения маршрутизаторов ВМ в одной из зон доступности региона us-central1-b физически потеряли связь с внешним миром. Хотя их возможность обмена данными друг с другом сохранилась, пользователи не могли получить к ним доступ хотя бы для того, чтобы понять, что происходит. После того, как в Google выявили проблему, трафик был перенаправлен с маршрутизаторов, отключенных инженером, на «работоспособные мощности в других частях региона». Затем инженеры вернули кабели назад и восстановили исходную конфигурацию сети. Предполагается, что виноватый в сбое инженер нарушил базовое требование, предполагающее чтение инструкций до того, как браться за работу. Человеческий фактор неоднократно становился причиной сбоев в США и за их пределами. Так, летом 2025 года австралийские военные по ошибке «положили» Wi-Fi и радио на побережье Новой Зеландии. В декабре 2025 года появилась новость, что лень и безалаберность инженеров Nokia и Optus в Австралии привели к смерти людей, которые не смогли дозвониться до скорой. Как отмечает Uptime Institute, сбои в дата-центрах стали реже, но значительнее. |
|

